Практические разборы по LLM и агентам за 21–28 сентября.
🗓 окно 21–28 сентября 2026⚡ статей 10👀 на заметку 3📡 отсканировано 357
📝 О чём пишут на этой неделе
В статьях этой недели агенту всё чаще задают проверяемую границу действия: тест перед отчётом об успехе, права на отдельный MCP-инструмент, контроль качества датасета. Авторы RAG-разборов отделяют ошибки поиска от ошибок ранжирования. Локальные модели оценивают на своём железе и показывают цену ускорения: короткий бенчмарк не заменяет полный прогон задачи.
⚡
Главные статьи недели
01
В RAG сначала найдите потерянный документ, затем настройте ранжирование
✍ Бромбин АндрейХабр⏱ ≈9 минБлог компании RUVDS.comИскусственный интеллект
О чём
Автор проверяет поиск по Налоговому кодексу: где нужный документ теряется и помогает ли повторное ранжирование. Метод полезен при настройке RAG, когда итоговый ответ уже не показывает причину промаха.
🔑 Главное
Сравнение dense, BM25 и гибридного поиска ведётся на одних и тех же вопросах.
Отдельно проверяются охват кандидатов и порядок первых десяти результатов.
Увеличение пула с 20 до 50 в этом опыте не улучшило Hit@10 и подняло задержку в 2,6 раза.
Из статьи↗
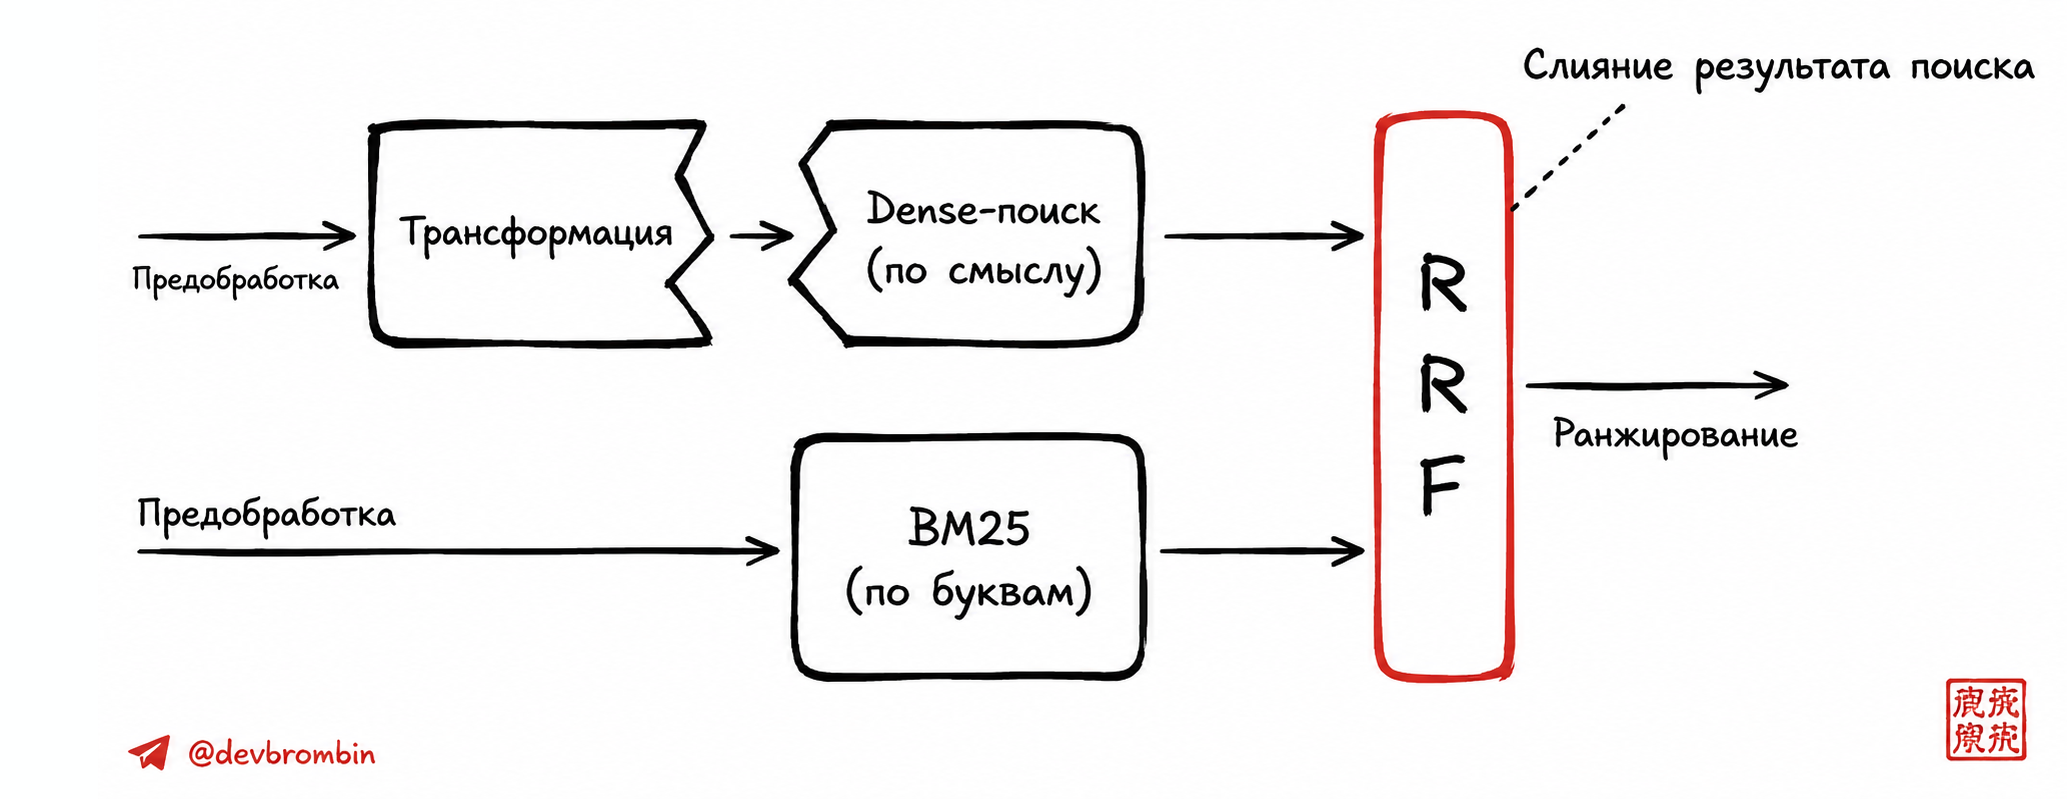
Схема статьи показывает, как dense-поиск и BM25 сходятся через RRF перед ранжированием.
⚡ Попробовать за вечер
Возьмите запрос, где поиск промахнулся, и отметьте, попал ли нужный документ в первые 20 кандидатов.
Сравните dense, BM25 и гибридный поиск; затем повторно ранжируйте один и тот же пул.
Метрика: зафиксируйте Hit@10, nDCG@10 и медианную задержку до и после.
Ограничение: Проверялся поиск, а не качество ответа LLM; дословные вопросы ФНС не опубликованы.
Статья показывает короткий набор файлов с картой проекта, доменными правилами, контрактами и одной задачей. Так агенту проще связать запрос с кодом и проверкой результата.
🔑 Главное
В `agent-context/index.md` перечисляются точка входа и места, где менять код.
Доменные ограничения и контракты лежат рядом с задачей, а не растворяются в длинном общем промпте.
Каждый критерий готовности автор предлагает привязать к тесту.
⚡ Попробовать за вечер
Создайте `agent-context/index.md`, `domain.md`, `contracts.md` и файл текущей задачи в `features/`.
Для одного критерия готовности укажите соответствующий тест и дайте агенту инструкцию из примера.
Метрика: проверьте, изменил ли агент нужный тест и прошёл ли он после правки.
Ограничение: Статья даёт пример и репозиторий, но не измеряет снижение ошибок агента.
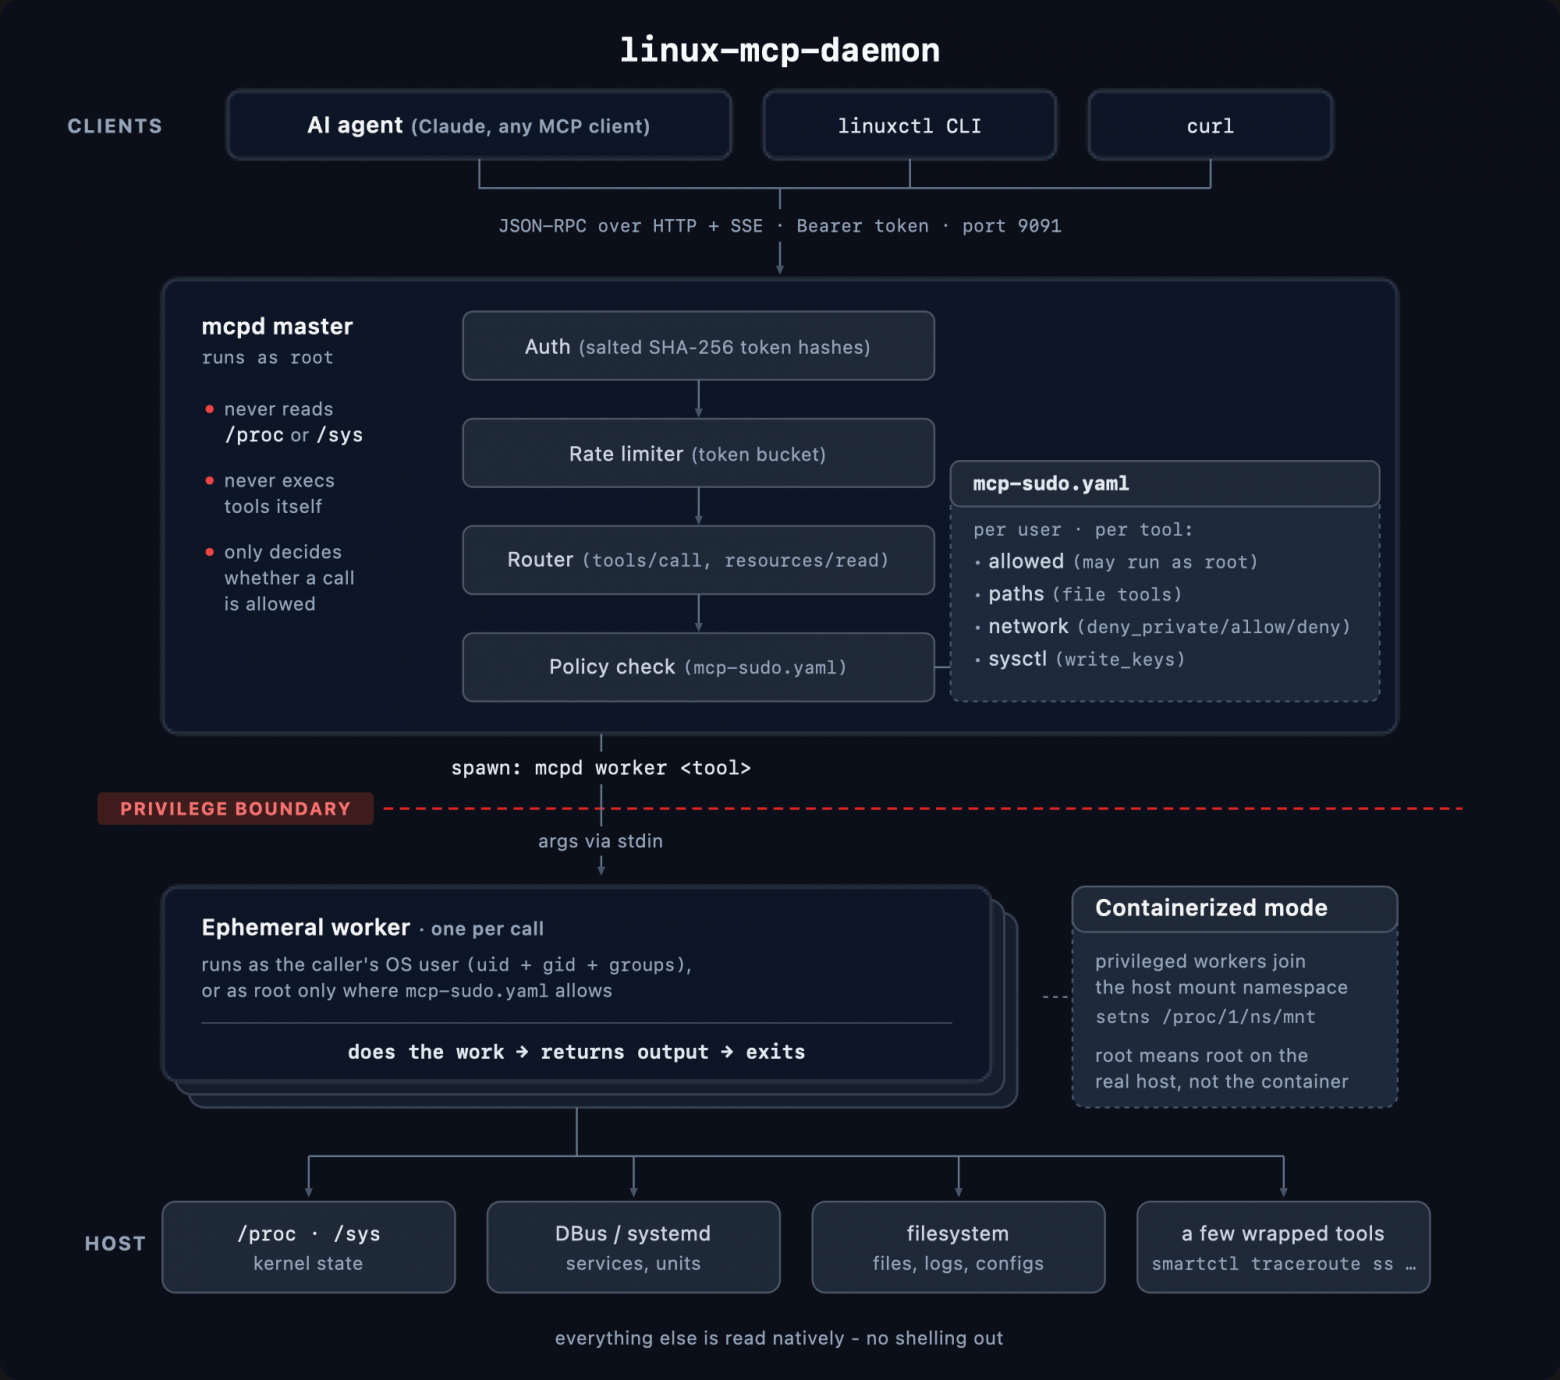
Автор подключает Linux-сервер к агенту через MCP и показывает, как отделить чтение журналов от действий с правами root. В центре материала — конфигурация разрешённых инструментов и путей.
🔑 Главное
В `mcp-sudo.yaml` права задаются для пользователя и конкретного инструмента.
`files/read` можно ограничить каталогом вроде `/var/log`.
При ограниченных путях демон проверяет компоненты пути и не следует по символической ссылке.
Из статьи↗
Архитектурная схема показывает, где агент проходит авторизацию и границу привилегий.
⚡ Попробовать за вечер
Разверните `linux-mcp-daemon` на тестовом Linux-хосте и выдайте агенту только `files/read` для одного каталога.
Попросите прочитать файл внутри разрешённого пути, затем вне него и через символическую ссылку.
Метрика: разрешённый запрос проходит, оба запретных возвращают отказ и не вызывают чтение файла.
Ограничение: Это демонстрация авторского Linux/systemd-стека, а не аудит безопасности MCP в целом.
Автор предлагает отделять написанный код от проверенного результата. Для интерфейса это означает выполнить действие в браузере и увидеть изменение DOM или ошибку консоли.
🔑 Главное
Один только просмотр кода не подтверждает, что кнопка или форма работает.
После записи файла полезно проверить недостающие ссылки и импорты.
Если выполнение проверить нельзя, агент должен сообщить об этом явно.
Из статьи↗
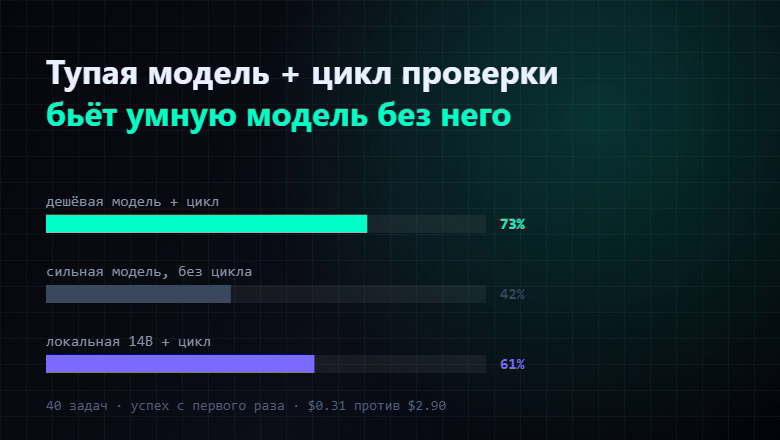
График автора сравнивает долю успешных задач модели с циклом проверки и без него.
⚡ Попробовать за вечер
Дайте агенту небольшую задачу с наблюдаемым эффектом, например переключение видимого элемента.
После правки запустите страницу, нажмите кнопку и прочитайте новое состояние DOM и ошибки консоли.
Метрика: считайте завершённой только задачу, где изменение состояния действительно наблюдалось.
Ограничение: Сравнение моделей 73% против 42% нельзя воспроизвести: набор задач и модели не раскрыты.
Tensor split ускорил генерацию на двух RTX 3060, но замедлил длинный prefill
✍ webthefirstХабр⏱ ≈22 минИскусственный интеллектМашинное обучение
О чём
Автор последовательно меняет разделение модели, KV-кеш и встроенный MTP в llama.cpp. Таблицы показывают, где выросла скорость генерации длинного контекста и какой ценой для первичной обработки запроса.
🔑 Главное
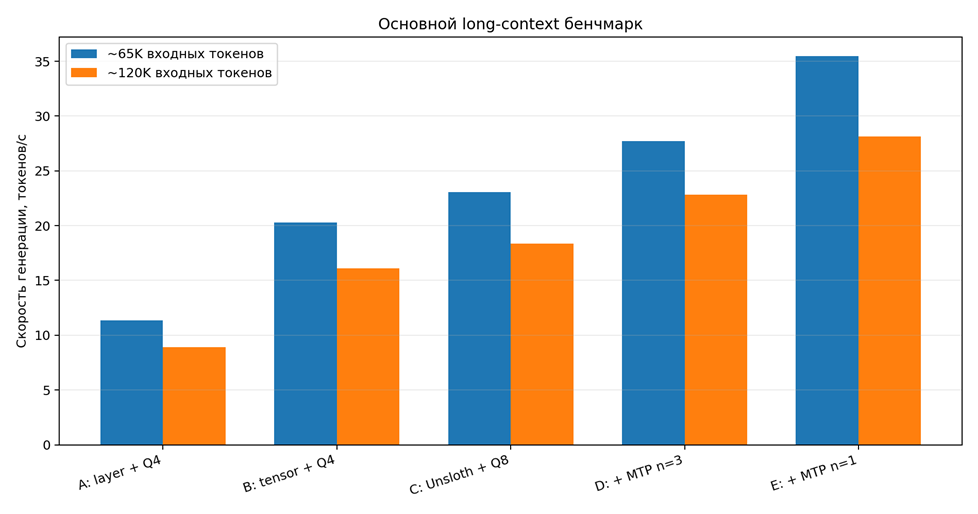
При переходе с `-sm layer` на `-sm tensor` генерация на ~120K выросла с 8,89 до 16,09 токена/с на стенде автора.
Каждую точку автор прогонял трижды на одной сборке llama.cpp.
При tensor split первоначальная обработка нового большого промпта стала медленнее.
Из статьи↗
График автора сравнивает скорость вариантов запуска на 65K и 120K входных токенов.
⚡ Попробовать за вечер
Повторите один запрос на своей двухкарточной машине с `-sm layer` и `-sm tensor`.
Запишите отдельно время prefill и скорость decode, затем проверьте конфигурацию с MTP.
Метрика: сравните полное время ответа, а не только токены в секунду генерации.
Ограничение: Цифры относятся к Z97 и двум RTX 3060 без CUDA P2P; результаты на другой шине могут отличаться.
Проверяйте ответ агента дешёвым правилом до вызова LLM-судьи
✍ eds88Хабр⏱ ≈16 минБлог компании Островок!Искусственный интеллект
О чём
Статья собирает каркас агента из планировщика, исполнителя и проверяющего блока. Код показывает, как проверять структуру результата до дорогой оценки моделью и менять глубину проверки при росте нагрузки.
🔑 Главное
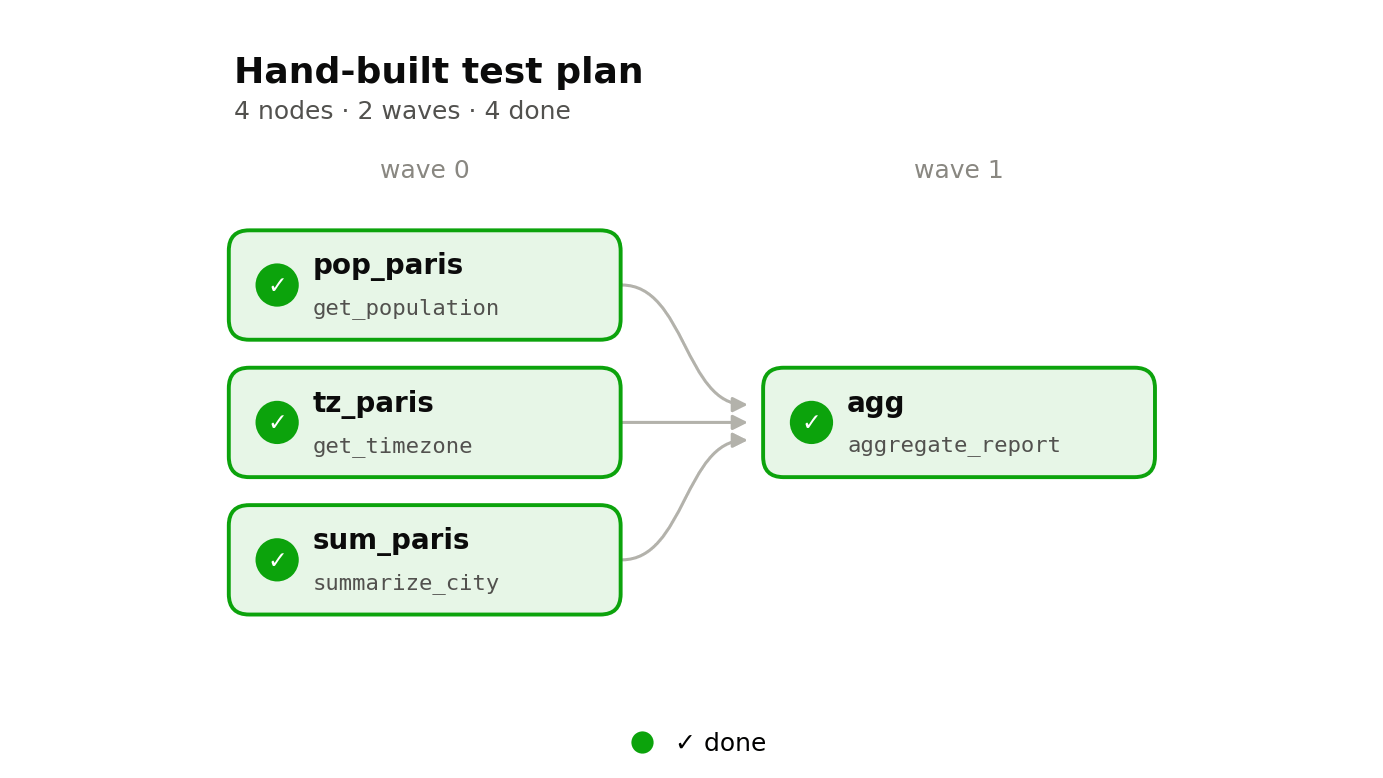
План хранится как валидируемый DAG задач, готовые узлы исполняются параллельно.
Детерминированная проверка ловит пропущенные поля до вызова LLM-судьи.
При высоком давлении на лимиты дорогая проверка пропускается по явно заданному порогу.
Из статьи↗
Скриншот тестового плана показывает параллельные узлы и сбор результата агентом.
⚡ Попробовать за вечер
Опишите результат одной задачи схемой Pydantic и добавьте проверку обязательных полей.
Пропускайте ответ через правило перед вызовом LLM-судьи; запишите причину отказа.
Метрика: посчитайте, сколько неверных ответов правило отсекло и сколько вызовов судьи сэкономило.
Ограничение: В статье есть фрагменты кода, но полного ноутбука для повторения всех опытов нет.
Считайте подтверждённые дефекты агента, а не черновые находки
✍ Алексей КовалевХабр⏱ ≈9 минТестирование IT-системИскусственный интеллект
О чём
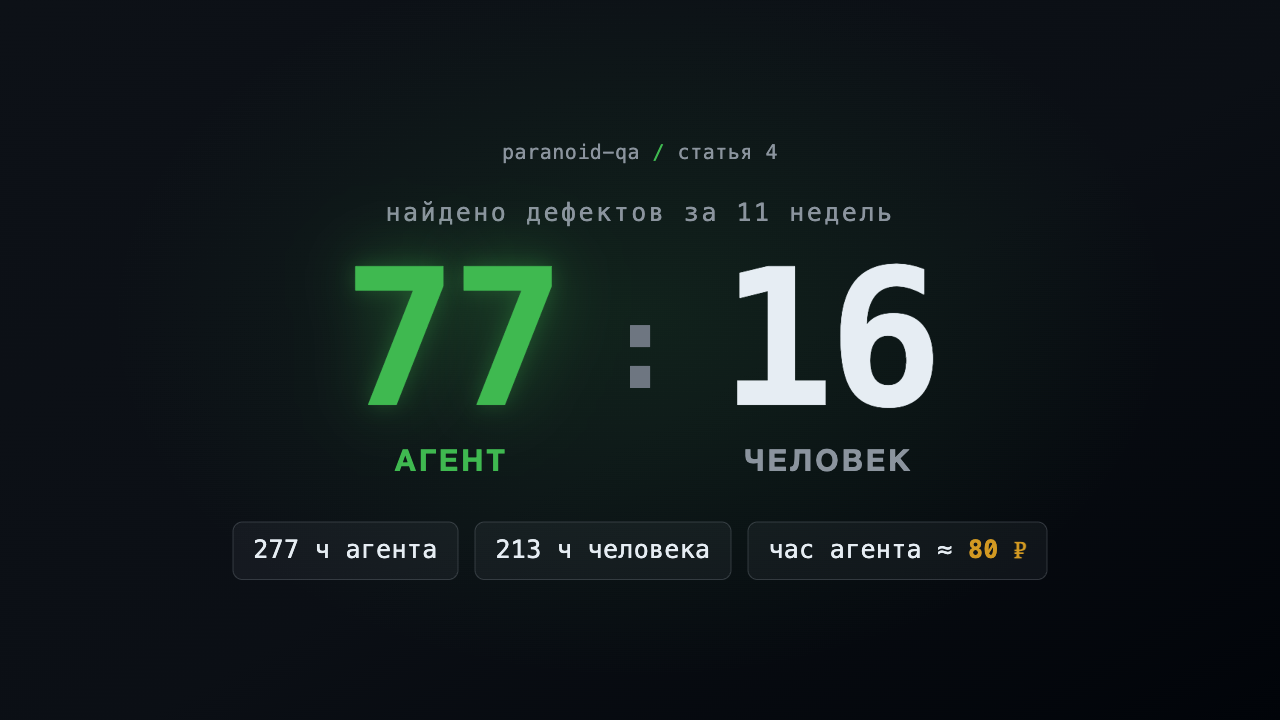
Один QA-инженер 11 недель сравнивал работу с AI-тестировщиком и без него. Полезнее всего его порядок проверки: каждый найденный агентом дефект сверять со спецификацией, интерфейсом и результатом ручного прогона.
🔑 Главное
Промежуточный список находок может сильно отличаться от финальных вердиктов.
Ошибочные ожидания в моках дали автору ложные `Fail`.
Для времени работы автор анализировал транскрипты сессий, а не только часы между стартом и концом.
Из статьи↗
Инфографика автора сопоставляет число найденных дефектов агентом и человеком за 11 недель.
⚡ Попробовать за вечер
Возьмите один тестовый сценарий и сохраните список дефектов, предложенный агентом.
Каждый `Fail` проверьте на реальном интерфейсе или API и сопоставьте с требованиями.
Метрика: отдельно посчитайте кандидатов в дефекты и подтверждённые дефекты.
Ограничение: Вердикты выносил сам автор; его оценку экономии нельзя переносить на другую команду.
Автор собирает llama.cpp и запускает Qwen3.8-Flash-Next на старой 11-ГБ видеокарте. Вычисления и веса распределяются между GPU, ОЗУ и CPU; статья даёт параметры сервера и проверку совместимого API.
🔑 Главное
Описаны квантовка GGUF, версия сборки и параметры `llama-server`.
Для кеша ключей и значений используются `q8_0`; число GPU-слоёв можно выбирать автоматически.
Около 11 токенов/с получено только на указанном стенде с 64 ГБ ОЗУ.
⚡ Попробовать за вечер
Сверьте объём ОЗУ и диска с требованиями выбранного GGUF и соберите llama.cpp для своей видеокарты.
Запустите `llama-server` с параметрами кеша из статьи и отправьте запрос в `/v1/chat/completions`.
Метрика: запишите токены в секунду и потребление памяти на собственном запросе.
Ограничение: Команды в извлечённом тексте местами склеены; скорость относится только к стенду автора.
Датасет атак проверяйте по успешным обходам и безопасным запросам
✍ Компания Just AIХабр⏱ ≈15 минБлог компании Just AIИнформационная безопасность
О чём
Авторы проверяют корпуса промпт-инъекций для детектора атак на AI-агентов. Их метод отделяет попытку атаки от подтверждённого успеха и требует отдельного набора безопасных запросов.
🔑 Главное
Примеры размечаются по источнику, технике и цели атаки.
Успех проб нужно проверять на целевых моделях, а не выводить из формулировки промпта.
Независимый безопасный набор нужен для оценки ложных тревог.
Из статьи↗
График статьи показывает различие результатов по типам атак на модели.
⚡ Попробовать за вечер
Возьмите небольшой набор атак и отметьте для каждой источник, технику и цель.
Прогоните примеры через две целевые модели, вручную отделите попытки от успешных обходов и добавьте безопасные запросы.
Метрика: считайте успешные обходы по типам атак и ложные тревоги на безопасном наборе.
Ограничение: Авторы не публикуют полный корпус и настройки детектора; ноль успехов на малой выборке не означает нулевой риск.
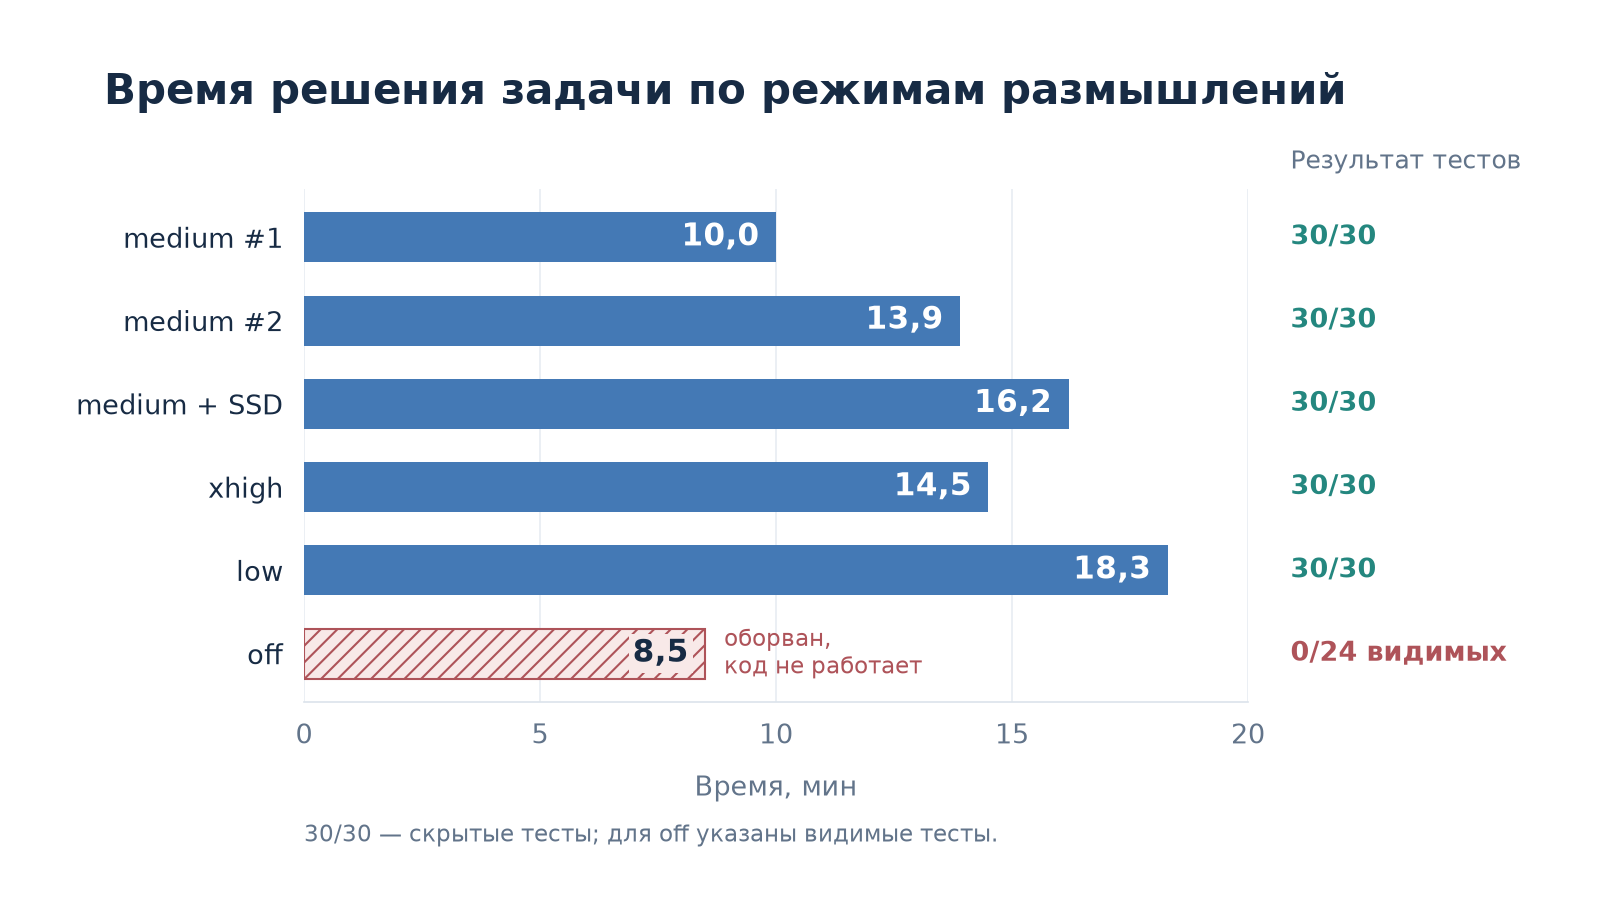
На Mac M4 Max автор соединяет MTPLX, pi и Qwen3.8-27B и меряет одну задачу программирования. Разброс повторных запусков оказался важнее ряда различий между режимами.
🔑 Главное
Запуски велись в чистой папке с одинаковым запросом.
Для режима medium получились 10, 14 и 16 минут.
Часть сравнений прервалась, поэтому вывод о постоянном ускорении агентных задач делать рано.
Из статьи↗
График показывает время решения и результат тестов для разных режимов размышления.
⚡ Попробовать за вечер
Возьмите небольшую задачу с открытыми и скрытыми тестами, зафиксируйте модель и параметры.
Запустите агента трижды с одним запросом в чистых каталогах.
Метрика: сравните распределение времени, прошедшие тесты и расход токенов, а не один лучший запуск.
Ограничение: Один Mac и одна синтетическая задача; некоторые режимы испытаны лишь один раз.
 Из статьи↗